工厂独立站内容做得不错,AI却从来不引用——问题常出在门口:robots.txt把AI爬虫拦住了。爬虫进不来,内容就永远进不了AI。这篇给你一份可直接复制的放行清单,10分钟改完、三步验证。
一、为什么GEO必须先管robots.txt
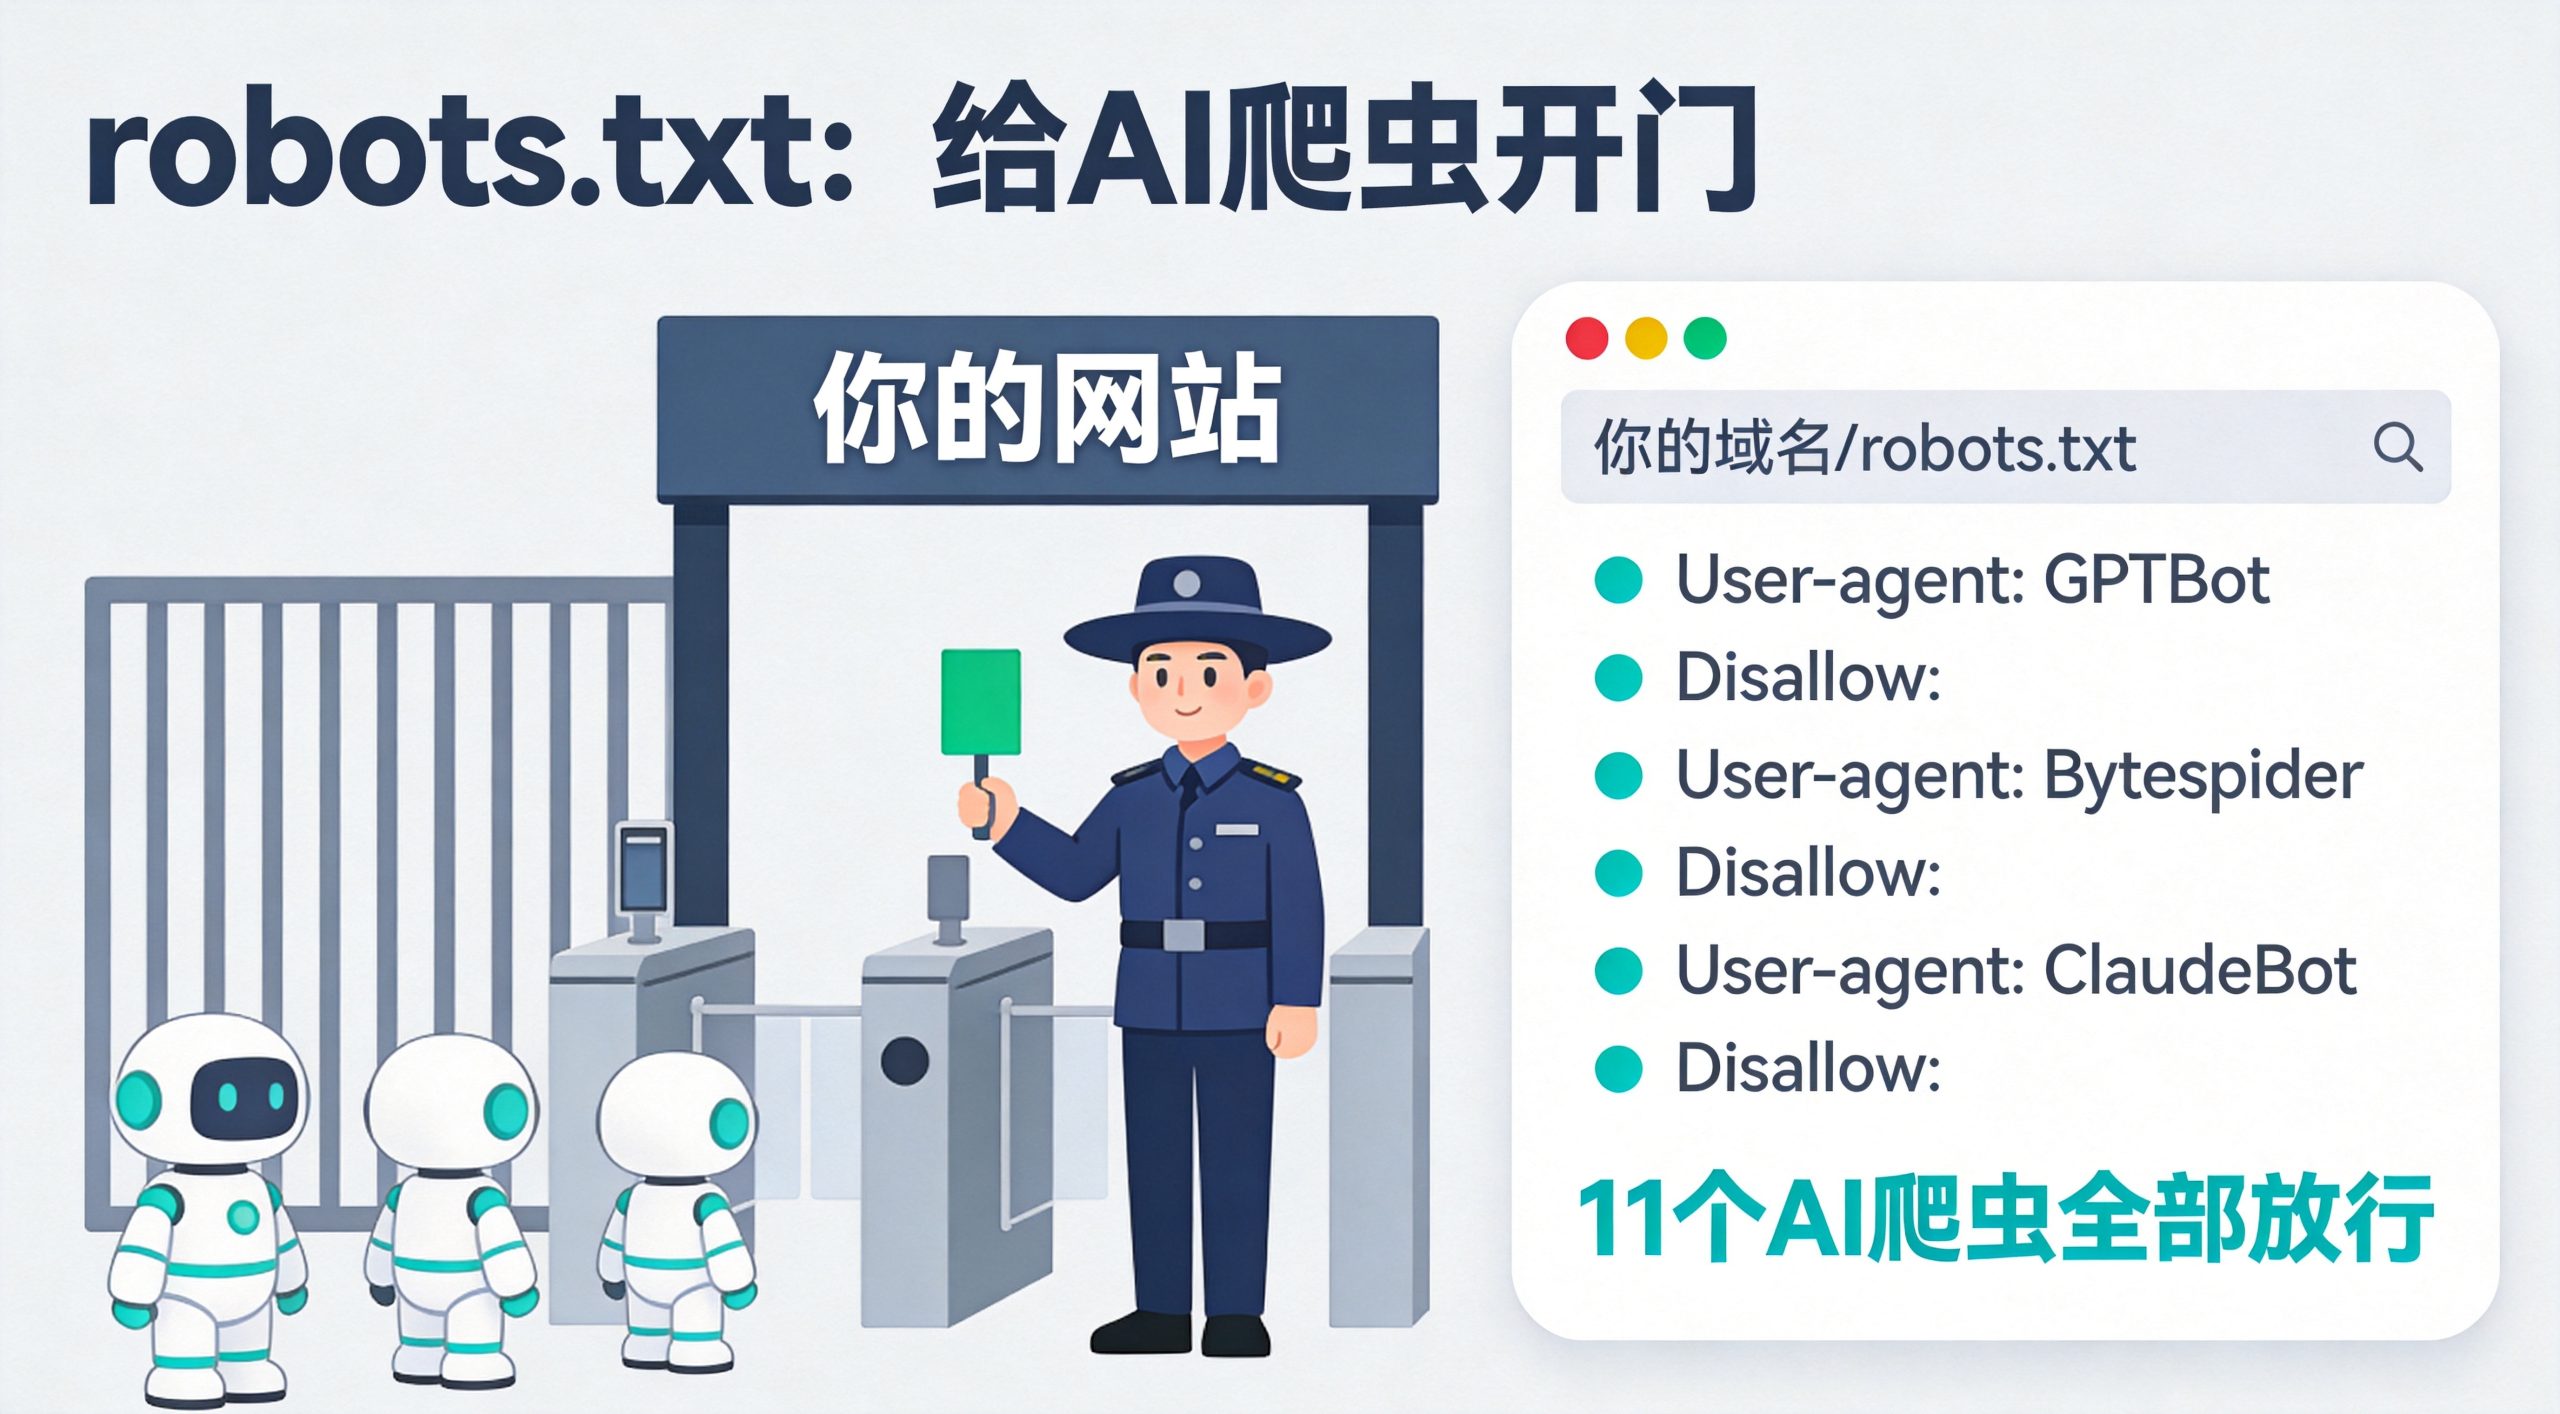
robots.txt是网站放在根目录的一个纯文本文件,是给所有爬虫看的“门禁告示”:爬虫来访先读它,它说不许抓,爬虫就不抓。
AI回答问题分两步:先抓取网页建库,再生成回答。门禁把AI爬虫拦在门外,后面内容写得再好、GEO做再多,都是白做——这是成本最低、也必须最先排掉的雷。
怎么判断自己有没有中招:浏览器打开“你的域名/robots.txt”,如果看到“User-agent: *”下面跟着“Disallow: /”,就是整站封禁,立刻改。
很多工厂站被拦属于“历史遗留”:建站时技术为了防采集,顺手把所有爬虫一刀切,上线后再没人管过这个文件。等你开始做GEO,内容发了几十篇,AI那边一篇都没收到——病根就在这张告示上。
动作:今天就用浏览器打开自己的robots.txt看一眼,只要30秒。能正常打开、没有整站封禁,再往下读;打不开或内容可疑,先修这一项,别的都往后排。
独立站GEO完整框架
二、主流AI爬虫UA对照表(11个)
硬交付物①:AI爬虫UA对照表
UA(User-Agent)是爬虫来访时报上的“身份名”,robots.txt按UA分别放行。外贸独立站要认识这11个:
| UA名称 | 归属产品 | 归属公司 |
|---|---|---|
| GPTBot | GPT系列模型训练抓取 | OpenAI |
| ChatGPT-User | ChatGPT联网回答时的实时抓取 | OpenAI |
| OAI-SearchBot | OpenAI搜索类产品抓取 | OpenAI |
| ClaudeBot | Claude模型训练抓取 | Anthropic |
| Claude-Web | Claude联网回答时的抓取 | Anthropic |
| PerplexityBot | Perplexity问答抓取 | Perplexity |
| Google-Extended | Gemini等Google AI产品训练 | |
| Googlebot | Google搜索索引 | |
| Bingbot | 微软Bing搜索(Copilot回答走Bing索引) | 微软 |
| Bytespider | 豆包等字节系AI产品 | 字节跳动 |
| Applebot | Apple Intelligence等苹果AI功能 | 苹果Apple |
注意分两类:GPTBot、ClaudeBot、Google-Extended管“训练建库”;ChatGPT-User、Claude-Web、PerplexityBot管“买家当场提问、AI联网抓网页”。两类都要放行——只放行训练类,买家提问时它还是抓不到你的新内容。
自检:拿这11个UA逐个在你的robots.txt里查一遍,缺哪个补哪个。
怎么判断该放行哪些:做外贸的工厂站,这11个建议全部放行。Googlebot和Bingbot本来就是搜索引擎蜘蛛——AI搜索和传统搜索共用索引,拦了它们等于同时丢掉两拨流量;其余9个AI爬虫带来的都是潜在买家的提问流量,没有封锁的道理。
有老板担心“放行会不会被人抄走产品资料”。要明确:robots.txt只是君子协定,拦得住守规矩的正规AI爬虫,拦不住恶意采集;真有保密页面,正确做法是后台加密或干脆不放进公开站点,而不是靠robots藏。
三、可直接复制的robots.txt完整代码(线上实例)
硬交付物②:可复制robots.txt完整代码(逐行讲解附后)
下面这份是 factorygeo.com 线上正在使用的真实配置——一个已上线运行的外贸GEO站点实例。WordPress独立站可整段复制:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /readme.html
Disallow: /license.txt

User-agent: GPTBot
Disallow:
User-agent: ChatGPT-User
Disallow:
User-agent: OAI-SearchBot
Disallow:
User-agent: PerplexityBot
Disallow:
User-agent: ClaudeBot
Disallow:
User-agent: Claude-Web
Disallow:
User-agent: Google-Extended
Disallow:
User-agent: Googlebot
Disallow:
User-agent: Bingbot
Disallow:
User-agent: Bytespider
Disallow:
User-agent: Applebot
Disallow:

Sitemap: https://factorygeo.com/sitemap_index.xml
逐行讲解
User-agent: *:通用规则段,对所有爬虫生效。
Disallow: /wp-admin/:屏蔽后台目录,后台不该被任何爬虫抓取。
Allow: /wp-admin/admin-ajax.php:这个接口前台页面也要调用,单独放行,否则部分前台功能会异常。
Disallow: /readme.html 和 /license.txt:WordPress自带的版本说明文件,屏蔽掉,不对外暴露程序版本。
每个AI爬虫段两行:User-agent 报身份,Disallow: 后面留空=允许抓取全站,一行都不拦。
Sitemap行:把网站地图地址主动报给爬虫,让它按图索骥抓全站,新页面进库更快。
放置位置:必须放在网站根目录,用“https://你的域名/robots.txt”能直接访问到,才算放对。
非WordPress站点:同样放根目录,删掉 wp-admin、readme.html、license.txt 这三行WordPress专属规则即可,AI爬虫段和Sitemap行原样保留。
动作四步:复制代码 → 把Sitemap行域名换成你自己的 → 上传到网站根目录 → 浏览器访问验证。
三个格式细节:文件名必须全小写 robots.txt,不是Robots.txt,也别让Windows记事本偷偷存成 robots.txt.txt;编码用UTF-8;每行一条规则,冒号后留一个空格,改完不要用Word排版保存。
WordPress站点还有个省事做法:在SEO类插件的“文件编辑器”里直接改robots,插件负责写进根目录,免去手动上传;但改完仍要走完下面的验证三步,别迷信插件。
四、配置后验证3步法
硬交付物③:配置验证3步法
文件传上去不算完,三步全过才算放行成功:
- 浏览器直查。访问“你的域名/robots.txt”,能看到刚上传的内容;看不到就是没放对目录或被缓存,换无痕窗口再试。
- 规则验证。用Google Search Console的robots.txt报告,或任意在线robots检测工具,输入你要放行的页面地址,确认返回“允许抓取”。
- 日志验证。一周后查服务器日志:宝塔面板在“网站→日志”里,或直接看Nginx/Apache日志,搜索 GPTBot、Bytespider、ClaudeBot 等UA,能看到200状态码的到访记录,就是真放行了。
日志里怎么看:打开日志搜UA名,看到“200”状态码=抓取成功;“404”=页面不存在,回去查Sitemap里的网址;“403”或“500”=服务器拦截或程序报错,找技术查防火墙和伪静态。只看得到Googlebot、看不到任何AI爬虫UA的,回头检查UA拼写和规则段位置。
验收标准:三步全过。只过了头一步不算完——文件可见,不代表爬虫真能抓。
GEO实操三步走
五、6个常见错误
- 整站封禁。User-agent: * 下面写了 Disallow: /,所有爬虫全拦,网站在搜索和AI里双双消失。
- 只传文件没交地图。Sitemap行缺失,或地图地址打开是404,爬虫抓得慢、新页面迟迟不进库。
- HTTPS和HTTP版本不一致。站点已开HTTPS,Sitemap还写着 http:// ,或两个版本各放了一份内容不一致的robots。
- 面板伪静态覆盖。宝塔或Nginx配置里对robots.txt做了重写,你上传的文件根本没生效——日志里迟迟看不到AI爬虫UA时,优先查这条。
- 只放行训练类爬虫。漏了 ChatGPT-User、Claude-Web 这类“当场联网抓取”的UA,买家提问时AI还是看不到你的新内容。
- 忽略WordPress虚拟robots。根目录没有实体文件时,WordPress会动态生成一份robots,你在后台改的内容可能根本没落盘。用宝塔或FTP进根目录看一眼,没有实体robots.txt就手动传一个——实体文件优先。
robots.txt是GEO里成本最低的一个动作,10分钟就能改完;不改,可能让后续所有内容投入打水漂。在外贸圈GEO团队的技术检查清单中,robots.txt放行是第一项——门不开,货再多也出不去。
FAQ:配置robots.txt时常问的4个问题
robots.txt改了多久生效?
文件上传后,爬虫下次来访就读新规则,通常几天之内;各平台抓取频率不同,以服务器日志里连续看到AI爬虫UA的200记录为准。不用等谁审批,但Sitemap建议同时在Google Search Console里提交一遍,加快进库。
改错了会不会被K站?
robots.txt写错不会直接招致处罚,最严重的后果是你自己写了整站Disallow,爬虫不抓、页面逐步从索引和AI回答里淡出——这是“自己关门”,不是被惩罚。发现后立即改回,下一轮抓取即恢复。
放行AI爬虫会不会拖慢服务器、被刷流量?
主流AI爬虫抓取频率克制,正常外贸站几乎无感。真有压力,可在服务器后台对单个UA设置抓取间隔,不要一禁了之——禁掉等于亲手关上AI入口。
我用的是SaaS模板建站,后台找不到robots.txt怎么办?
多数SaaS建站平台在后台“域名/SEO设置”里提供robots编辑入口,或默认已放行;找不到就提交工单,明确要求“放行GPTBot、Bytespider等AI爬虫并附上Sitemap地址”。平台若不支持自定义,把这一条列入换站评估项。
作者:外贸圈GEO团队